Laboratoires de la Forêt-Noire

FLUX 3 — Modèles du monde réel

Le nouveau modèle de base multimodal de Black Forest Labs apprend conjointement à partir d'images, de vidéos et d'audio au sein d'une architecture unifiée, car l'intelligence visuelle nécessite de comprendre comment les objets tiennent ensemble, comment les choses bougent et comment les événements sonnent.

Optional first frame · PNG, JPG, WebP

Vidéo Flux 3
250

Génération dans l’espace de création

Ordinary portraits allowed · No celebrity likenesses. Safety policy

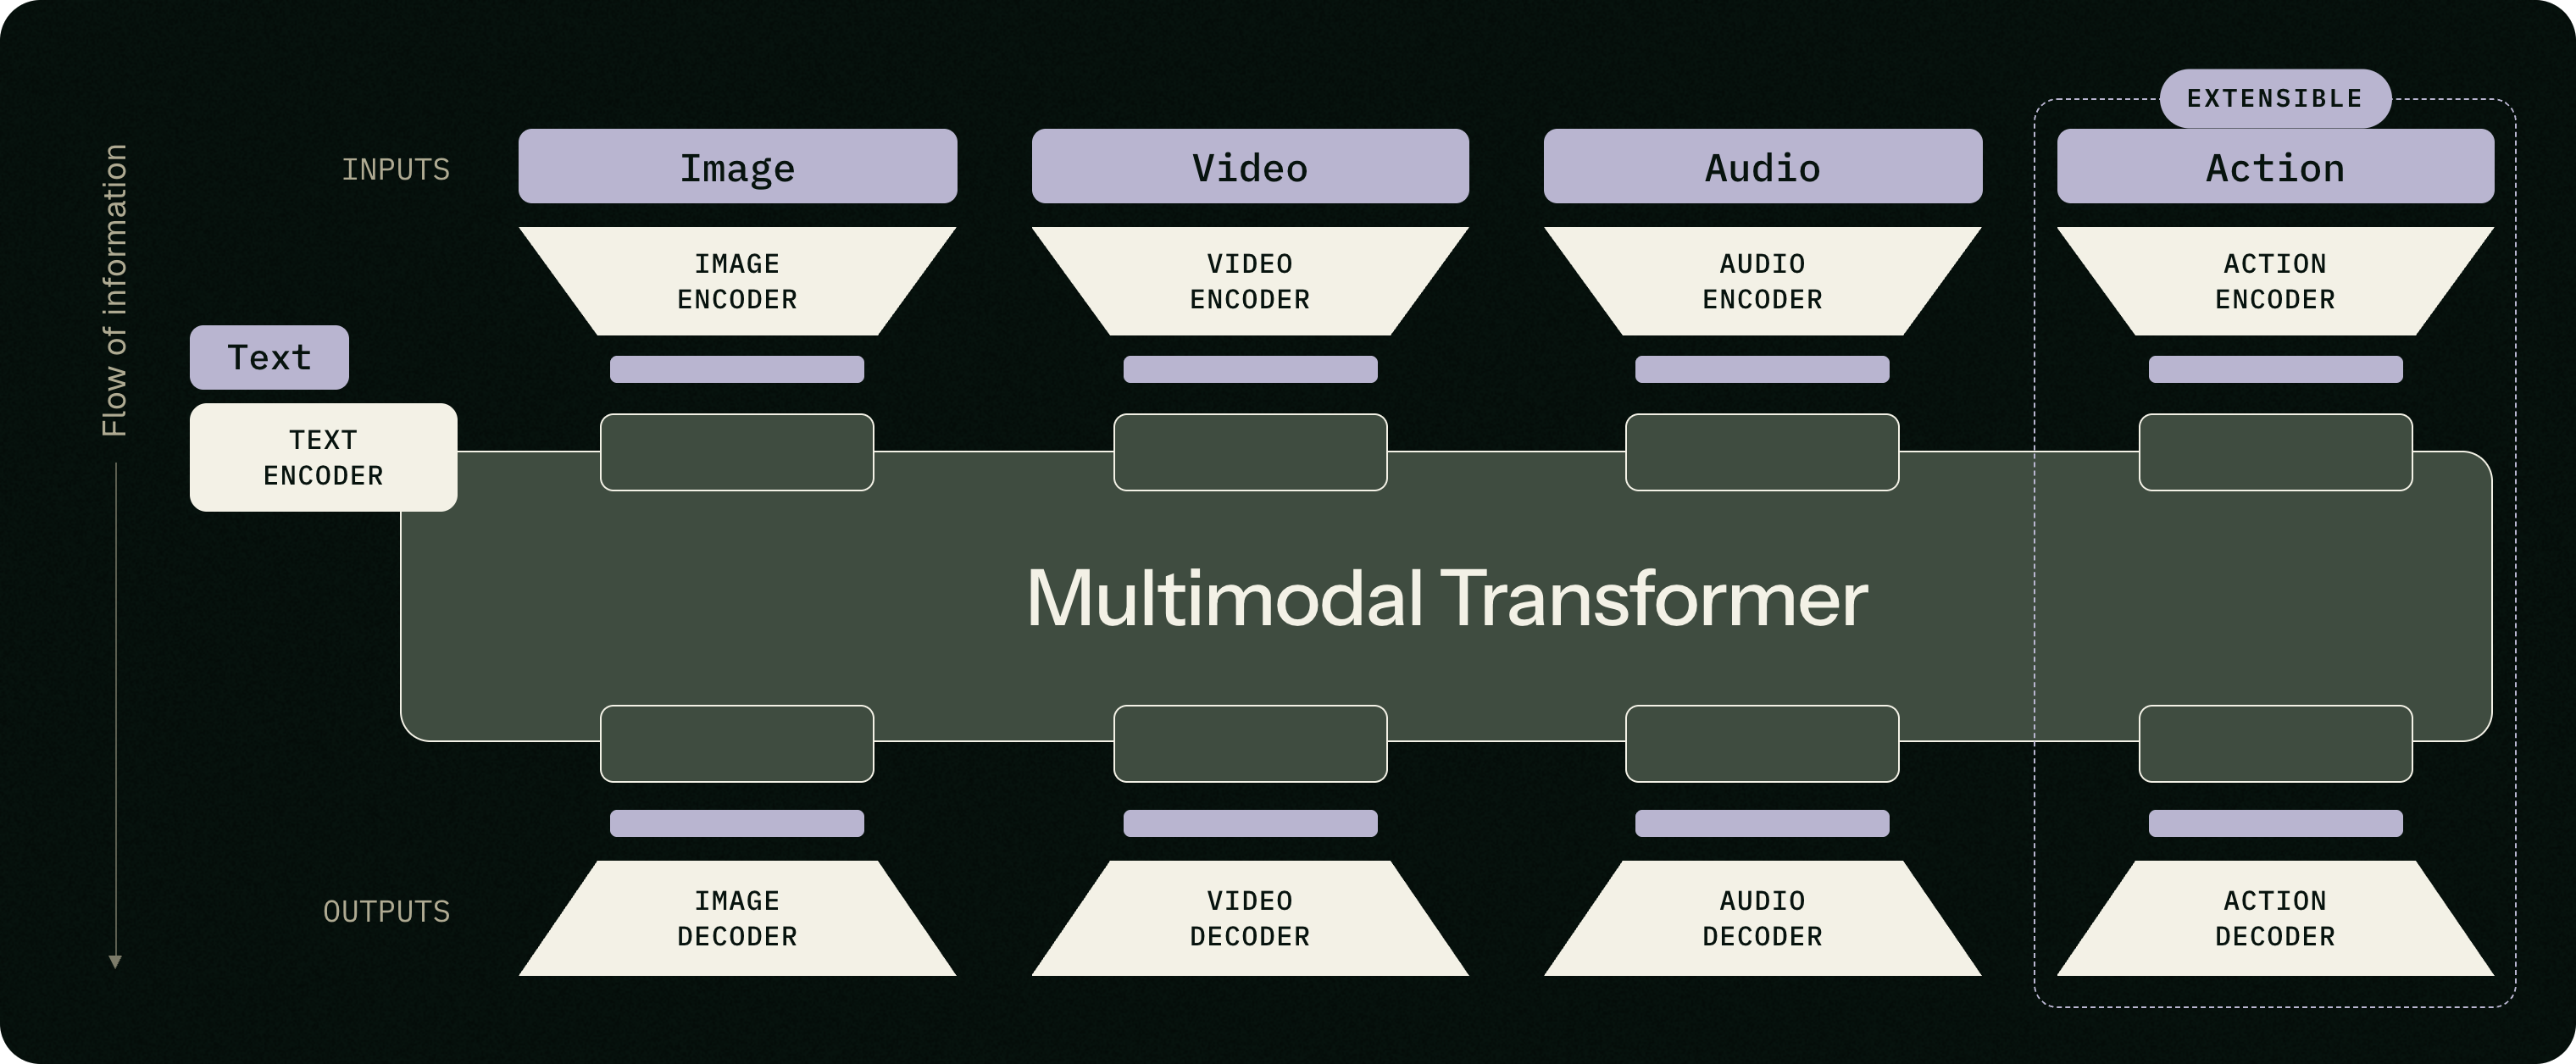
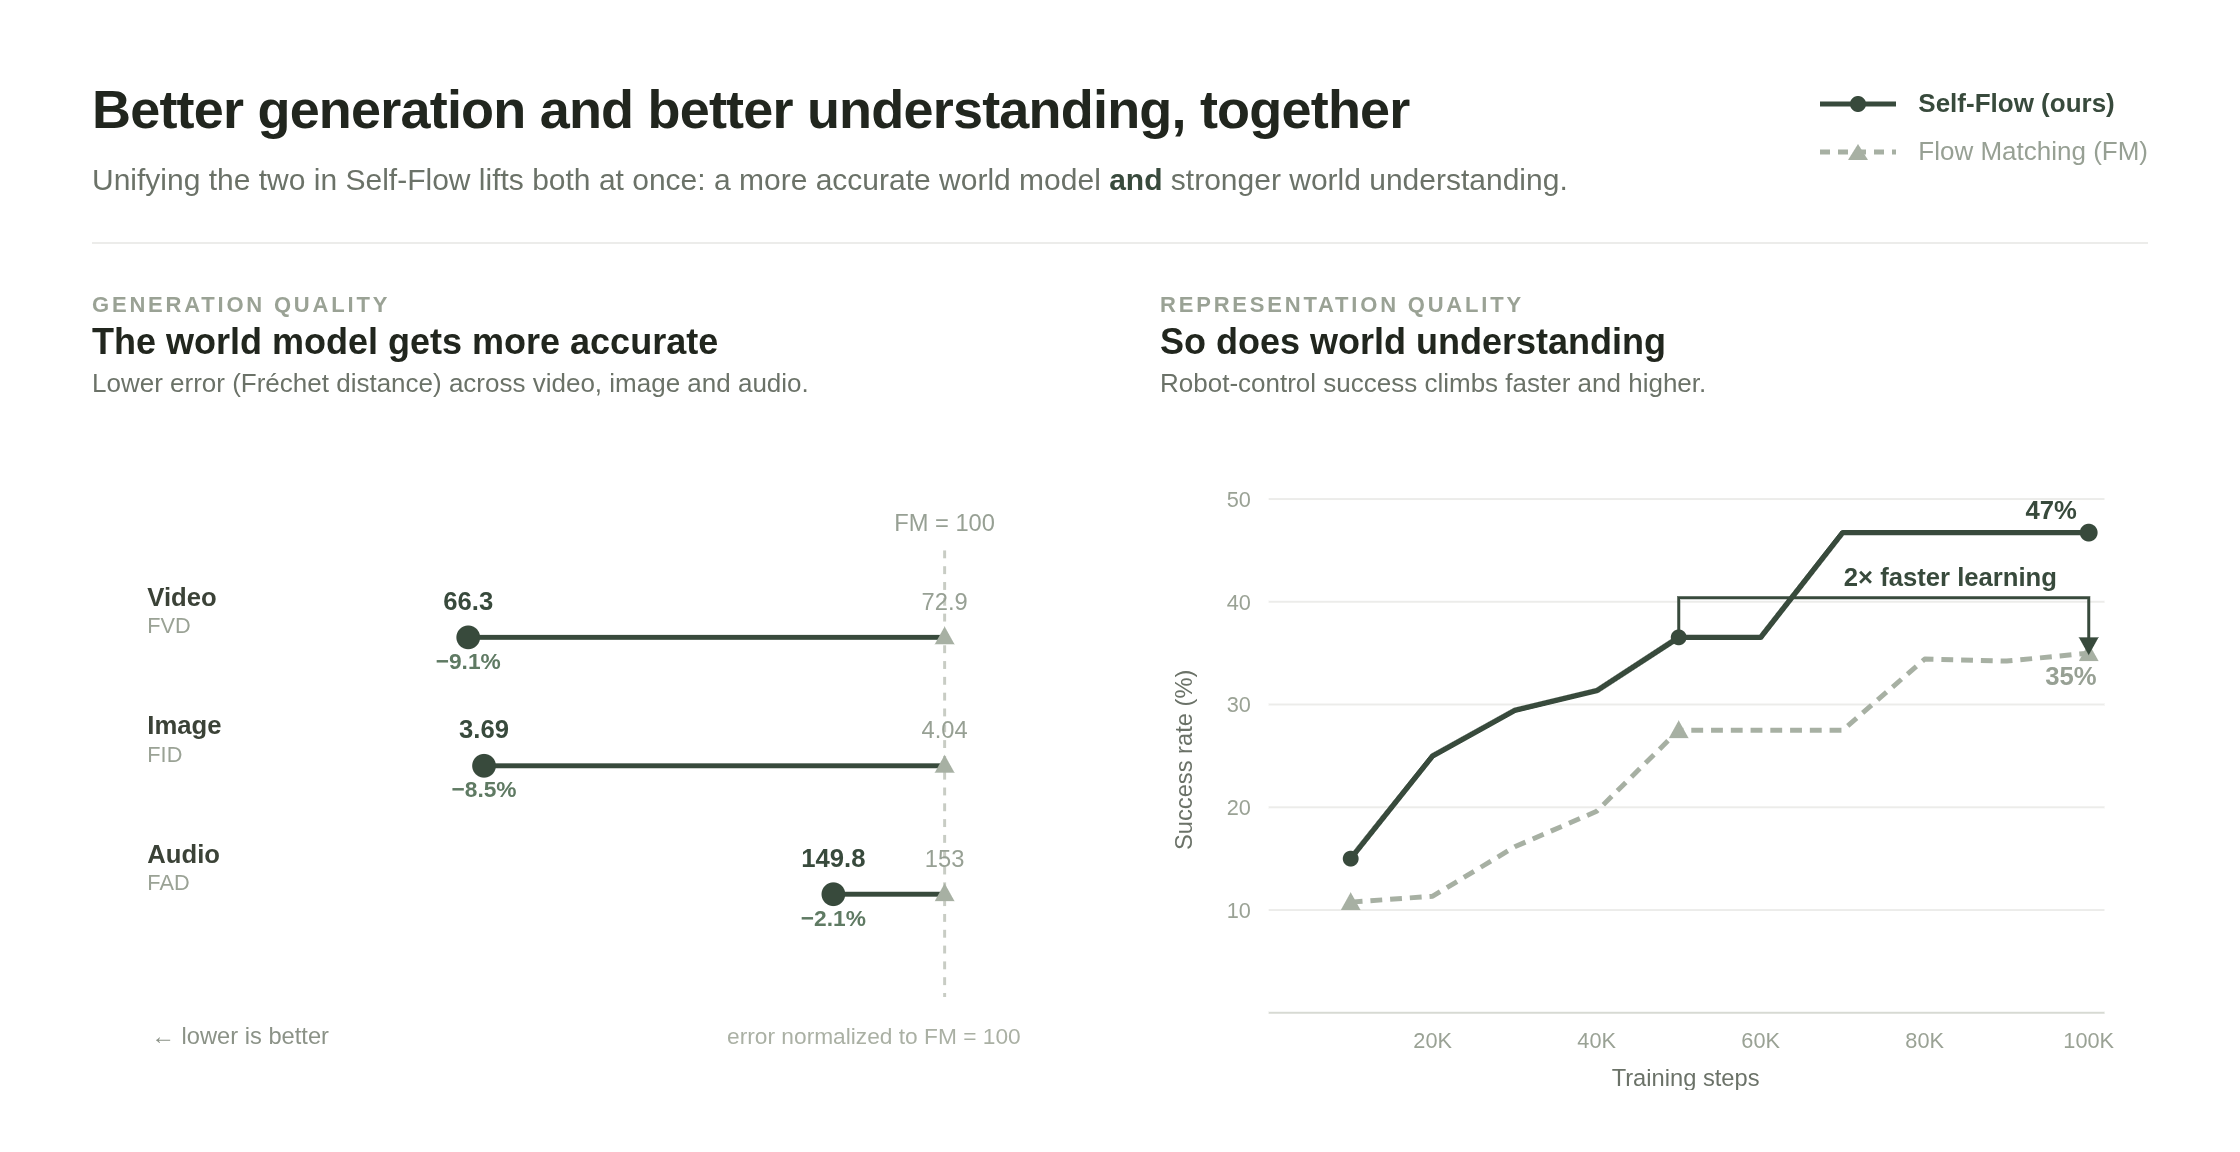
FLUX 3 est construit sur Self-Flow — alignant efficacement la génération et la compréhension multimodales au sein de la même architecture — s'étendant simultanément à la vidéo, aux images et à l'audio.

Pourquoi FLUX 3 change la génération multimodale

Un modèle, une réalité sous-jacente

Les images, vidéos et audio sont des projections du même monde capturées par différents capteurs. FLUX 3 apprend de chacun d'eux en même temps : le son correspond à l'impact, le mouvement obéit à la masse et l'avenir découle du passé.

Architecture à flux automatique

Architecture à flux automatique

Basé sur Self-Flow, BFL a considérablement adapté le calcul et les données pour former la génération et la compréhension dans le même modèle sous-jacent, améliorant ainsi à la fois la qualité et les performances des tâches en aval.

Mélanger librement les modalités

FLUX 3 peut générer des images et des vidéos avec de l'audio conjointement à partir d'invites de texte, ou combiner des références d'entrée telles que des images et des clips vidéo pour transporter des personnages, des styles et un contexte dans de nouvelles scènes.

Vers l'intelligence visuelle

Vers l'intelligence visuelle

FLUX 3 est un point de contrôle sur la mission de BFL visant à développer une intelligence visuelle du monde réel : des modèles qui perçoivent, prédisent et agissent dans des environnements physiques et numériques.

Black Forest Labs déploie les fonctionnalités de FLUX 3 par phases, chacune étant construite à partir du même modèle de correspondance de flux multimodal sous-jacent, avec un accès anticipé pour les commentaires et les tests de sécurité.

Plan de lancement de FLUX 3

FLUX 3 est conçu pour les créateurs, les spécialistes du marketing, les concepteurs, les équipes de robotique et tous ceux qui recherchent un partenaire créatif intelligent, et pas seulement un convertisseur à modalité unique.

À qui s’adresse FLUX 3

Créateurs et cinéastes

Générez des clips cinématographiques avec un son natif, des dialogues multilingues et une diversité de styles, des séquences de caméscope spontanées à l'animation. Enchaînez les clips en séquences multi-plans plus longues avec des personnages cohérents.
Marketeurs et équipes visuelles

Produisez des concepts de campagne, des variantes raffinées et des conceptions riches en typographie avec un raisonnement agentique. Ancrez les générations dans des références et itérez plus rapidement dans les flux de travail d'images et de vidéos.

IA physique et robotique

IA physique et robotique

Utilisez la compréhension du monde de FLUX 3 pour prédire les actions. FLUX-mimic affine la structure vidéo pour une manipulation adroite avec des données spécifiques à des tâches limitées, reliant ainsi la création de contenu et l'IA physique.

La prochaine colonne vertébrale de l'intelligence visuelle

Du montage interactif d'images et de vidéos à la simulation, en passant par l'utilisation d'un ordinateur et l'IA physique, FLUX 3 ouvre une large frontière. La génération vidéo est disponible en accès anticipé dès aujourd'hui.

Un modèle unifié alimente la vidéo, l’image et l’action – chaque modalité bénéficiant d’une compréhension partagée du monde formée à travers les images, les vidéos et l’audio.

Capacités du FLUX 3

Vidéo avec audio natif (jusqu'à 20 s)

Texte vers vidéo, animation image vers vidéo, transfert de référence vidéo vers vidéo, continuation vidéo-audio générative et contrôle d'image clé vers vidéo, le tout avec une génération audio native synchronisée.

Dialogue multilingue et conception sonore

Fort dans la capture des expressions faciales humaines, l'association des sons à des événements physiques et la génération de dialogues multilingues, en combinant les capacités en séquences de plusieurs minutes.

Diversité des styles et typographie

La gestion s'étend des séquences de caméscope spontanées à l'animation et aux cinématiques. Génération de typographie solide et conceptions animées dans une large gamme de styles visuels et de formats d'image.

Enchaînement multi-shots agentique

Enchaînez des clips individuels en séquences multi-prises plus longues. Les références visuelles aident à garantir que les personnages restent cohérents dans toutes les scènes tout au long des récits prolongés.

Synthèse et édition d'images

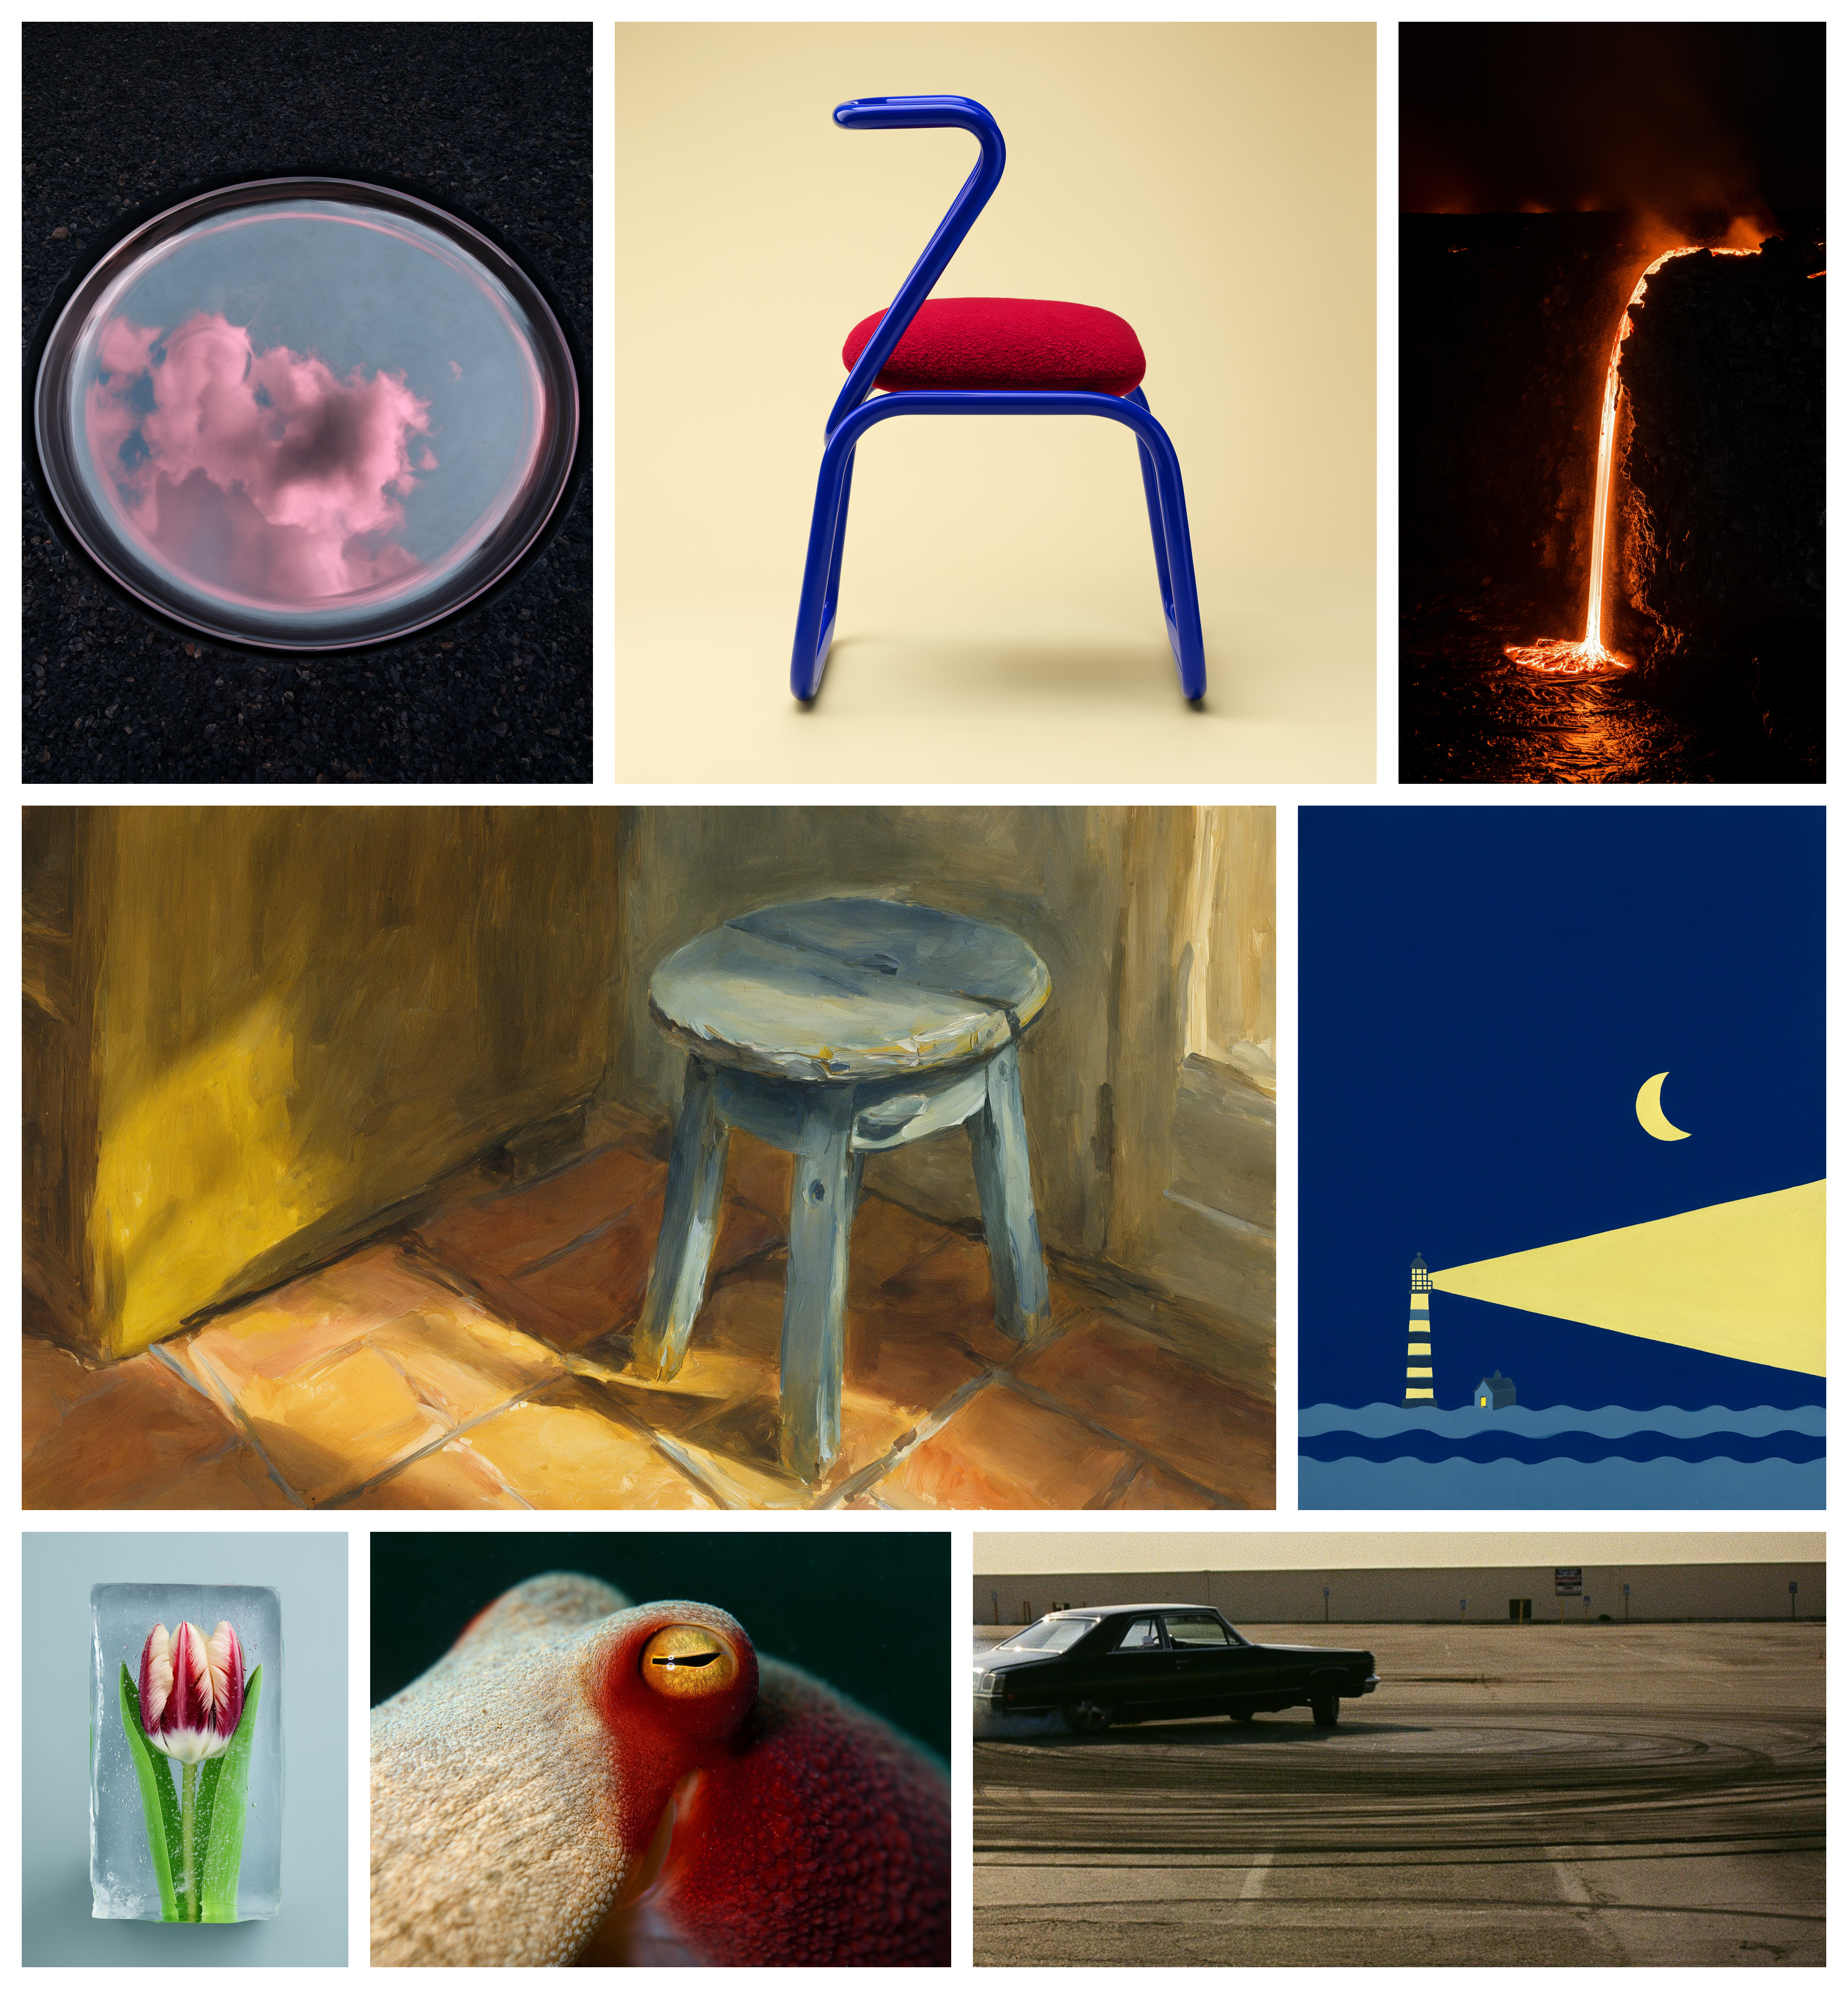
Synthétisez et modifiez des images dans une grande variété de styles, de formats et de résolutions. Amélioration du respect des invites complexes et du rendu du texte de haute précision dans plusieurs langues.

Prédiction des actions

Prédiction d'action native intégrée directement dans FLUX 3, ainsi que des modèles spécialisés affinés tels que FLUX-mimic, en utilisant le squelette vidéo pré-entraîné comme base prenant en compte la dynamique.

Performances de référence précoces

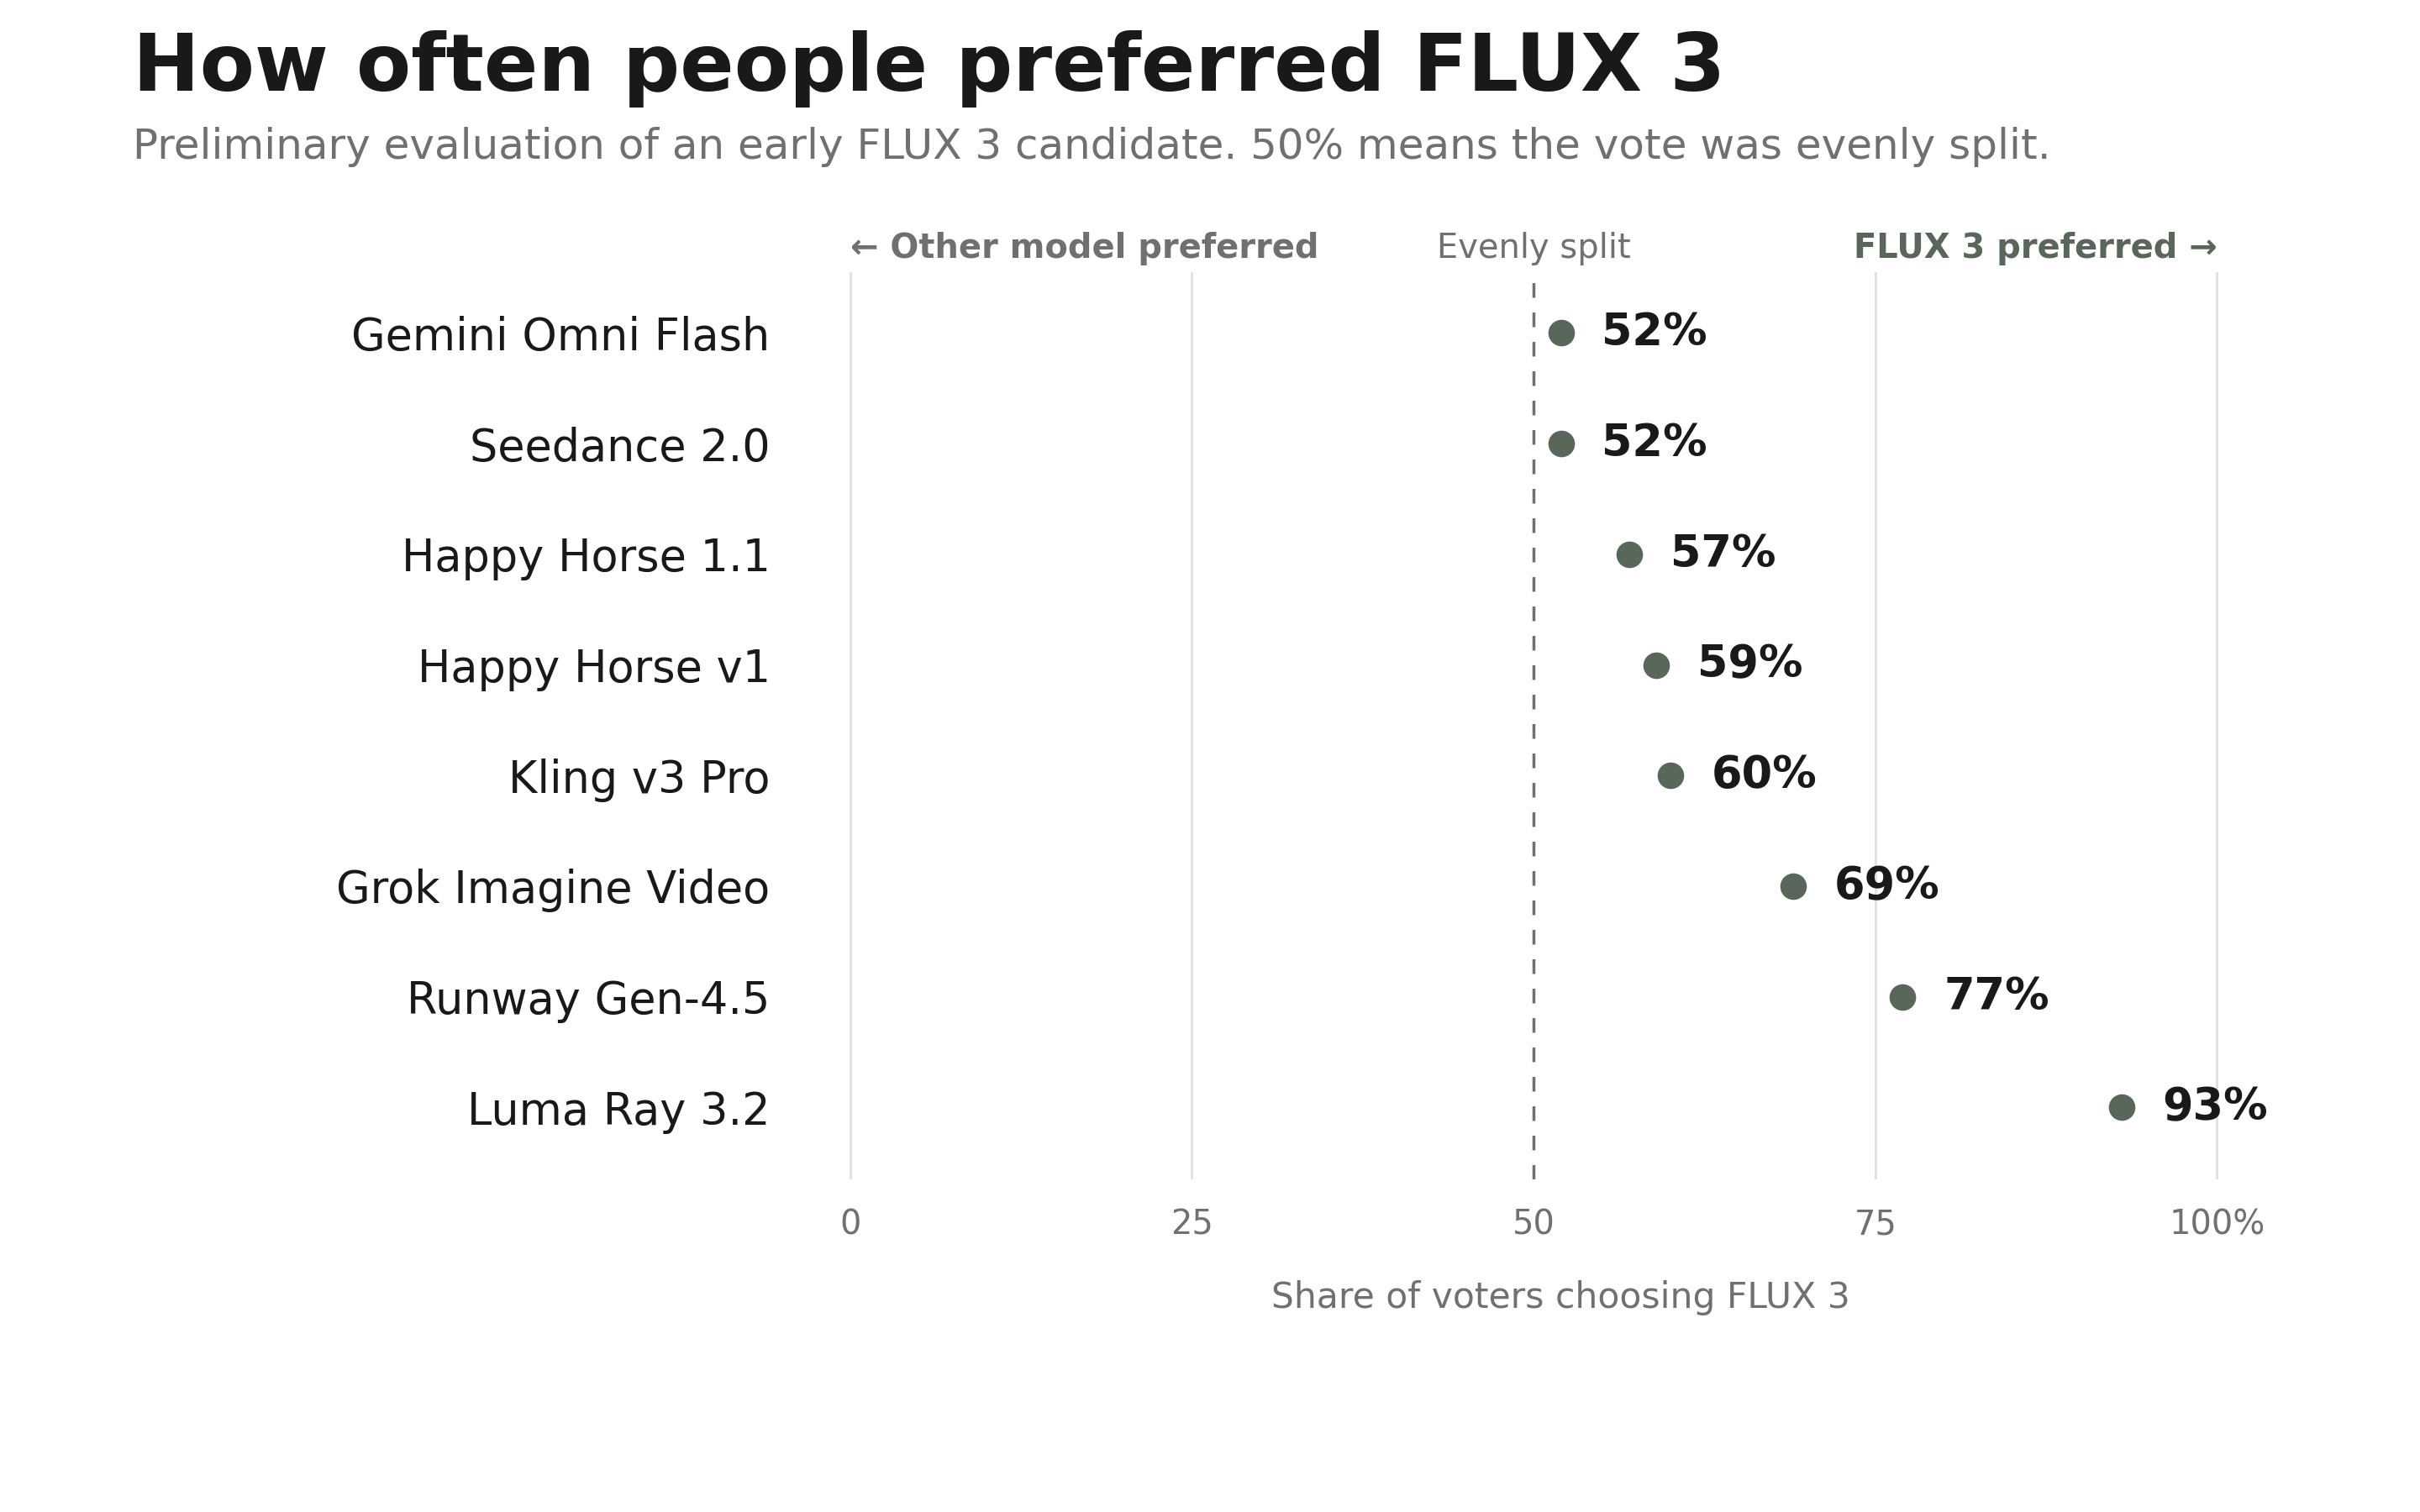
Lors des évaluations préliminaires de conversion texte-vidéo 720p, FLUX 3 a été préféré à plusieurs modèles phares dans les comparaisons directes – avec d'autres améliorations attendues lors de l'accès anticipé.

Questions fréquemment posées sur FLUX 3

Cette page résume les informations accessibles au public sur FLUX 3 de Black Forest Labs. Nous ne sommes pas affiliés à BFL.